
Modelet e reja Gemini TTS të Google mund të klonojnë një zë nga vetëm 30 sekonda audio
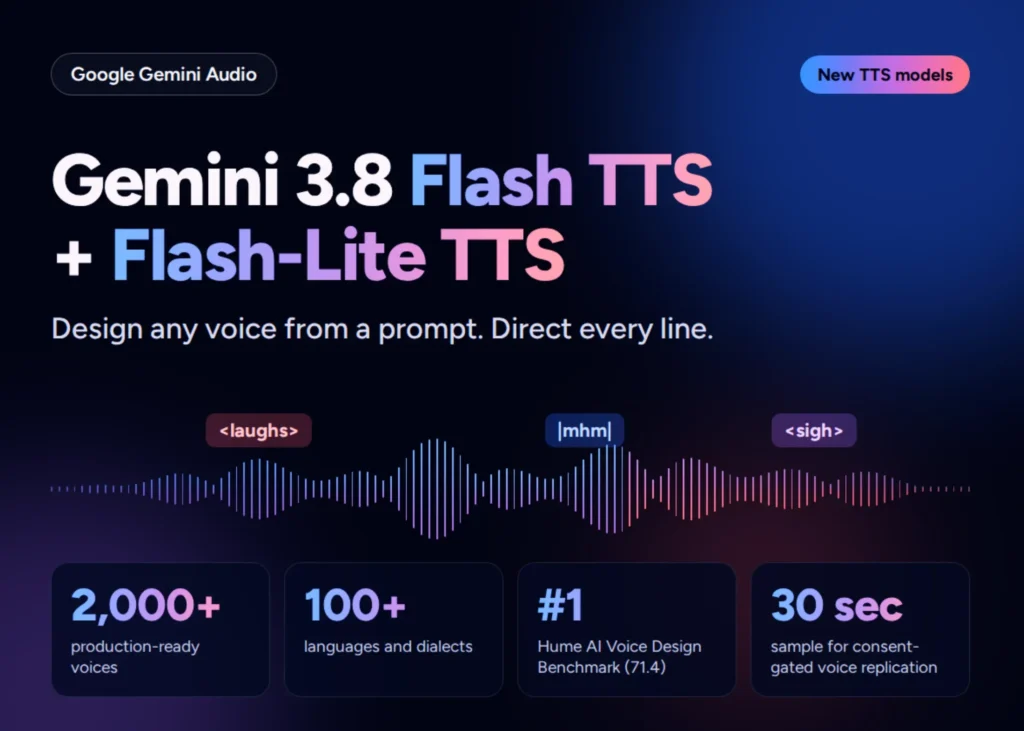
Google ka publikuar Gemini 3.8 Flash TTS dhe Flash-Lite TTS. Përdoruesit mund të krijojnë zëra të rinj nga një mesazh teksti ose të zgjedhin nga më shumë se 2,000 zëra të gatshëm. Flash TTS gjithashtu mund të rikrijojë një zë nga një mostër 30-sekondëshe pas një kontrolli pëlqimi.
“Sot, po prezantojmë dy modele të reja të konvertimit të tekstit në të folur në familjen Gemini, duke transformuar gjenerimin e zërit nga paracaktimet statike në një studio krijuese dinamike”, shkroi Google në njoftimin e saj.
Google lançoi Gemini 3.8 Flash TTS dhe Gemini 3.8 Flash-Lite TTS të mërkurën. Të dyja do të lançohen që nga sot në Gemini API dhe Google AI Studio. Ato i bashkohen familjes Gemini 3.8, të cilën Google e lançoi më parë këtë muaj.
Flash TTS është ndërtuar për punë krijuese si lojëra, audiolibra dhe podkaste. Flash-Lite TTS është opsioni më i lirë dhe me volum të lartë, i destinuar për dublim dhe agjentë zanorë, sipas Google.
Me Flash TTS, përdoruesit mund të krijojnë një zë të ri nga e para duke përshkruar rolin, theksin dhe karakteristikat e tij në gjuhë të thjeshtë, në më shumë se 100 gjuhë dhe dialekte. Shembujt e Google përfshijnë një DJ me energji të lartë nga Melbourne dhe një dragua japonez.
Përdoruesit mund të zgjedhin gjithashtu nga një bibliotekë me më shumë se 2,000 zëra të gatshëm, duke përfshirë variante rajonale si spanjishtja meksikane, frëngjishtja e Kebekut dhe anglishtja skoceze. Zërat e personalizuar mund të ruhen për ripërdorim në të gjitha projektet. Një funksion i ripërzierjes së zërave, i cili rregullon timbrin, lartësinë, ritmin dhe theksin, do të vijë së shpejti.
Të dy modelet u lejojnë përdoruesve të drejtojnë transmetimin rresht pas rreshti me udhëzime skenike. Ato mbështesin skena me dy folës nga një skenar i vetëm dhe audio të gjatë që zgjat orë të tëra. Skenarët mund të përfshijnë sinjale të tilla si të qeshura, psherëtima dhe ndërhyrje të shkurtra si “mhm”.
Flash TTS gjithashtu mund të rikrijojë një zë nga një mostër audio 30-sekondëshe. Google thotë se përdoruesit duhet të japin një regjistrim me pëlqim verbal nga pronari i zërit dhe sistemi kontrollon nëse përputhet me folësin referues përpara se të krijojë zërin.
Çdo klip i gjeneruar nga modelet Gemini Audio të Google mbart një filigran SynthID, sipas kompanisë. Zërat e replikuar mbartin gjithashtu kredencialet e përmbajtjes C2PA.
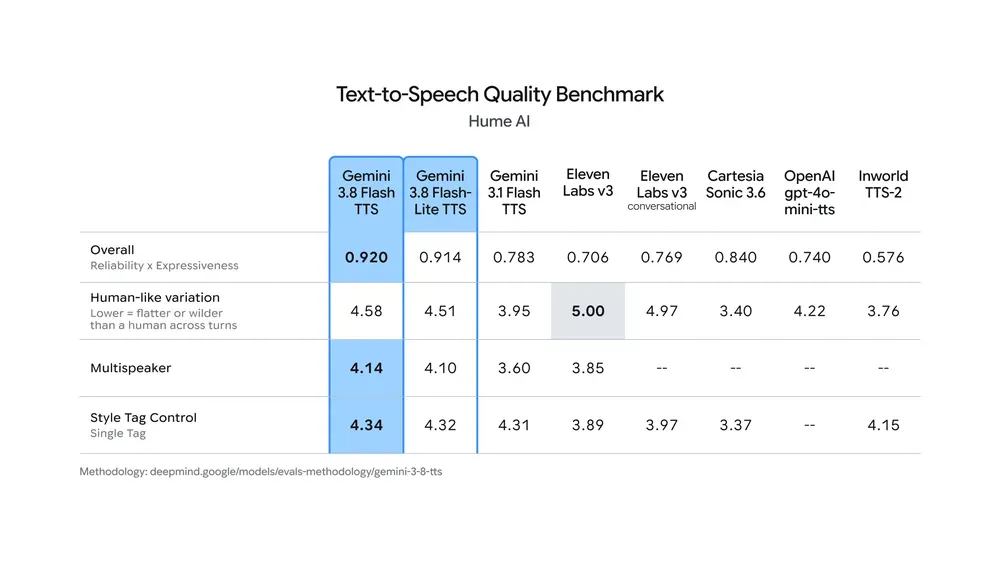
Google thotë se Flash TTS zuri vendin e parë në Hume AI’s Voice Design Benchmark, me një rezultat prej 71.4. Thuhet se Flash TTS dhe Flash-Lite TTS u renditën gjithashtu të parët dhe të dytët në Indeksin e Përgjithshëm të Cilësisë së Hume AI. Në testet e preferencës së verbër në Voice Arena, modelet siguruan pozicione të larta në gjuhë duke përfshirë japonishten, hindishten dhe spanjishten meksikane, sipas Google.
Tregu tashmë ka specialistë të tillë si ElevenLabs dhe Murf AI i Indisë, ndërsa Adobe shtoi gjenerimin e të folurit në Firefly në gusht. Google emëroi Figma, HeyGen, Wondercraft, Linguana, 99.co dhe Ollang si kompani që integrojnë modelet e reja.
Flash TTS do të vijë gjithashtu në Gemini Notebook dhe Flash-Lite TTS në Google Vids. Qasja për ndërmarrjet përmes Gemini Enterprise do të vijë së shpejti.