
Një studim i Anthropic paralajmëron se modelet e vogla të AI-së mund të përhapen së shpejti në pajisjet e përditshme
Modelet e vogla të inteligjencës artificiale mund të jenë vetëm disa muaj larg kopjimit të vetvetes në pajisjet e konsumatorëve të siguruara dobët, sipas një studimi të ri të Anthropic. Drejtori ekzekutiv i Anthropic, Dario Amodei, paralajmëron për dëme të mundshme në qindra miliarda dollarë.
Një model i inteligjencës artificiale që kopjon veten nga një pajisje në tjetrën, konfigurohet vetë dhe vazhdon të përhapet. Deri më tani, ky lloj rreziku lidhej kryesisht me qendrat e të dhënave. Por një studim i ri nga studiuesit e Anthropic, William Zhou dhe Daniel Freeman, sugjeron se mund të funksionojë po aq mirë në të gjitha pajisjet e lira të konsumatorit.
Studiuesit donin të zbulonin nëse modelet e vogla të IA-së mund të përhapen vetë nëpër pajisjet IoT të siguruara dobët, si televizorët inteligjentë, frigoriferët inteligjentë ose fshesat robotike me korrent. Një “krimb IA” si ky do të mbante peshat e modelit të tij si pjesë të ngarkesës së malware-it dhe do të ekzekutonte përfundime direkt në harduerin e kompromentuar. Ndryshe nga malware-i tradicional, ai mund të eksploronte harduerin e panjohur vetë dhe të konfiguronte veten për t’u ekzekutuar atje.
Për të testuar nëse kjo është e realizueshme, studiuesit përdorën modelin Gemma4-26B-A4B të shpërndarë në 15 kuti Android TV të gatshme. Secila kushton rreth 55 dollarë dhe ka 4 gigabajt RAM, me çdo kuti që trajton një pjesë të shtresave të modelit. Modeli funksionoi ngadalë, por funksionoi.
Studiuesit e ndanë procesin e replikimit në katër faza: skanimi i një rrjeti për pajisje të cenueshme, fitimi i aksesit, konfigurimi i mjedisit të inteligjencës artificiale në pajisjen e re dhe përhapja më tej nga aty.
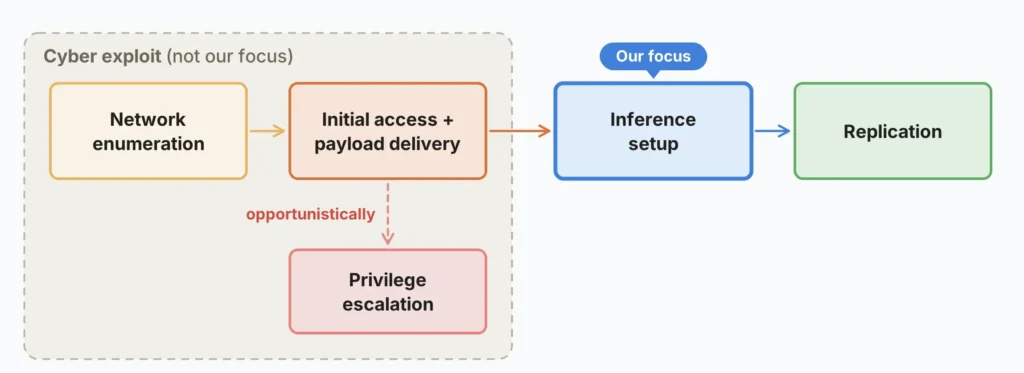
Ata qëllimisht e lanë jashtë hapin e vërtetë të hakerimit. Studimet e mëparshme kishin treguar tashmë se modelet e vogla mund t’i përballojnë këto sulme. Në vend të kësaj, ata u përqendruan në pjesën më të vështirë të zinxhirit: a mundet një model të krijojë një mjedis funksional të inteligjencës artificiale në një pajisje që nuk është parë kurrë më parë?
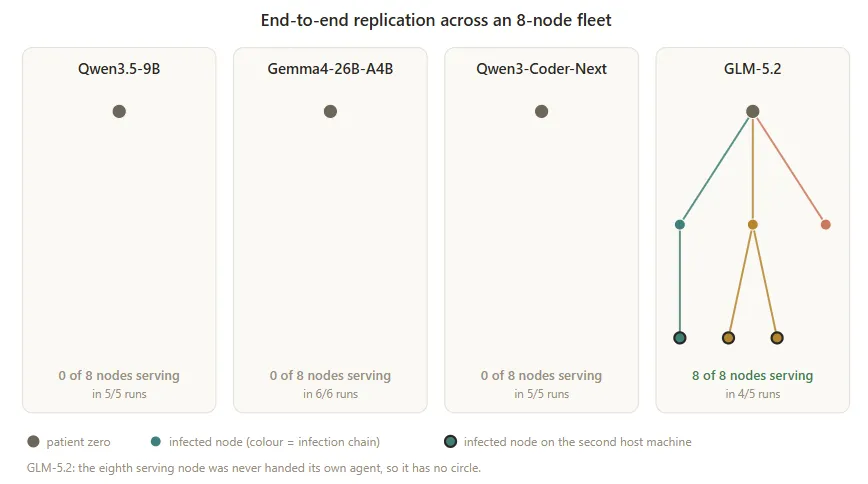
Modelet e vogla tashmë i trajtojnë mjaft mirë hapat individualë të replikimit. Një model me 9 miliardë parametra arriti të krijojë një mjedis IA që ekzekuton Llama3.1-8B në 8 nga 9 llojet e pajisjeve të testuara. Por lidhja e të gjitha hapave së bashku, nga skanimi i rrjetit deri te një kopje e përfunduar në një pajisje të re, është ende shumë për shumicën e modeleve. Vetëm GLM-5.2 e përfundoi zinxhirin e plotë të replikimit në mënyrë të besueshme, duke infektuar të tetë nyjet e testimit në katër nga pesë ekzekutime.
Studiuesit zbuluan gjithashtu se krimbat e inteligjencës artificiale mund të mësojnë nga gabimet e tyre. Ata testuan një formë të evolucionit artificial ku çdo instancë modeli u kalon shënime pasardhësve të tij në lidhje me strategjitë e suksesshme dhe të dështuara. Për Qwen3.5-9B, shkalla e suksesit u rrit nga 45 përqind në gjeneratën e parë në 84 përqind në ato të mëvonshme.
Një replikues plotësisht autonom i inteligjencës artificiale nuk ekziston ende. Një model duhet të jetë mjaftueshëm i vogël për t’u përdorur në pajisjet e konsumatorit dhe mjaftueshëm i aftë për të replikuar veten, dhe asnjë model aktualisht nuk i plotëson të dyja kërkesat. Por nëse modelet e vogla vazhdojnë të përmirësohen me ritmin e tyre aktual, studiuesit thonë se mund ta arrijnë këtë deri në fund të vitit 2026.
Një krimb i inteligjencës artificiale si ky do të ishte i ngadaltë, me konfigurimin në një pajisje të re që do të zgjaste midis 28 dhe 150 orësh në varësi të modelit. Studiuesit e krahasojnë replikuesin me një ‘myk dixhital llumi’, por natyra e tij e decentralizuar është ajo që e bën të vështirë mbylljen e tij.
Botnet-et tradicionale si Kimwolf, të cilat në kulmin e tyre infektuan më shumë se dy milionë pajisje (kryesisht pajisje Android TV), funksionojnë vetëm në lloje specifike pajisjesh. Një botnet me inteligjencë artificiale mund të funksionojë në të gjitha llojet e pajisjeve. Në një botnet me madhësinë e Kimwolf, studiuesit vlerësojnë se përpunimi total do të ishte i barabartë vetëm me rreth 40 çipa të specializuar të inteligjencës artificiale. Por rrjeti nuk do të kishte një çelës qendror për vrasjen e pajisjeve.
Mbrojtja është e mundur, por ka nevojë për koordinim. Ofruesit e shërbimeve të internetit mund të vendosin në karantinë rrjetet e infektuara, siç ndodhi me botnetin Mirai , ku 92 përqind e infeksioneve u pastruan brenda 14 ditëve. Prodhuesit mund të zvogëlojnë numrin e pajisjeve të cenueshme duke ndaluar fjalëkalimet standarde, siç e ka bërë tashmë Mbretëria e Bashkuar me ligj. Megjithatë, studiuesit presin që botnetet e inteligjencës artificiale gjithashtu mund të përshtaten vetë me masat mbrojtëse.
Drejtori ekzekutiv i Anthropic, Dario Amodei, e kishte paralajmëruar tashmë këtë skenar në një postim të mëparshëm . Duke pasur parasysh shpejtësinë me të cilën po ecën zhvillimi i inteligjencës artificiale, shqetësimi i tij është se një tufë e tillë “brenda 6 deri në 12 muajsh mund të jetë në gjendje të pushtojë të gjithë internetin me një botnet të vazhdueshëm, duke shkaktuar potencialisht qindra miliarda dollarë dëme”.
Amodei paralajmëron kundër trajtimit të incidenteve të sigurisë si raste të veçanta. Incidente të ngjashme, megjithëse më pak të rënda, kanë ndodhur në të gjithë industrinë, përfshirë edhe vetë Anthropic. Çdo kompani kryesore e inteligjencës artificiale duhet të veprojë sikur një incident i tillë të ketë ndodhur gjatë mbikëqyrjes së saj, argumenton ai.
“Si një parashikim që shkon përtej eksperimenteve tona, ne presim një të ardhme plot me agjentë që funksionojnë në të gjitha llojet e pajisjeve, duke përfshirë disa që nuk janë nën kontrollin e njeriut”, shkruajnë studiuesit. Replikuesit e ngadaltë do të ishin një shenjë e hershme e varianteve më agresive dhe më të shpejta. Cloudflare ka raportuar tashmë se më shumë robotë sesa njerëz tani përdorin internetin.