
Google prezanton dy çipa të rinj të inteligjencës artificiale për agjentët AI
Google LLC prezantoi sot dy çipa të rinj silikoni të specializuar për inteligjencën artificiale në familjen e arkitekturës së Njësisë së Përpunimit Tensor të gjeneratës së tetë, që synojnë dendësi më të lartë llogaritëse dhe inferencë të sigurt.
Në Google Cloud Next 2026 në prill, Google prezantoi dy TPU të specializuara në të njëjtën gjeneratë, 8t për trajnim në shkallë të gjerë dhe 8i të projektuar për arsyetim në kohë reale. Në atë kohë, kompania tha se lançoi çipat për të trajtuar ngarkesat e punës të kërkuara të IA-së në dy detyra kryesore: ndërtimin e modeleve dhe ekzekutimin e tyre.
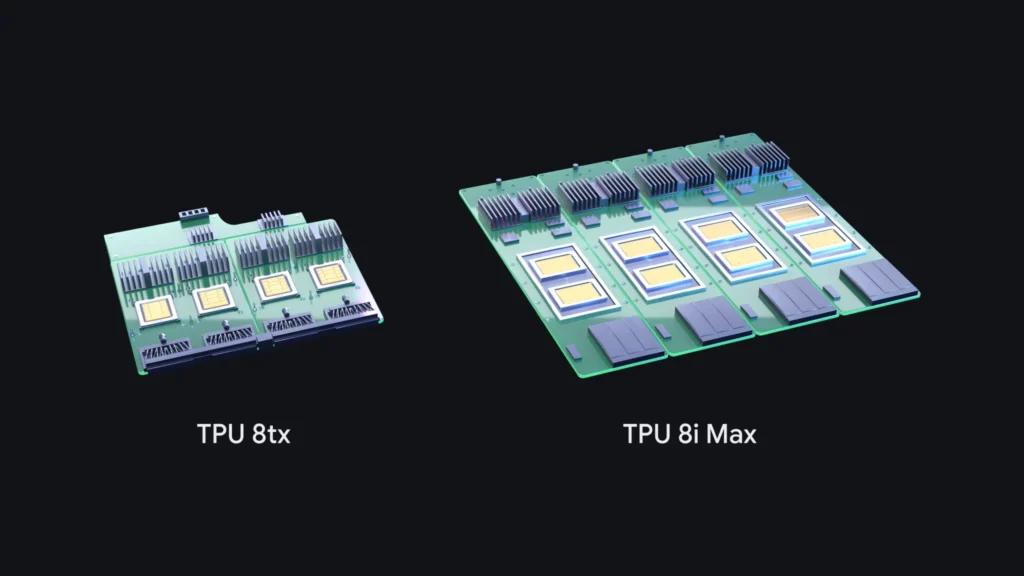
Zgjerimi i sotëm përfshin dy çipa të rinj të specializuar në sisteme të tjera: TPU 8i Max për dritare masive konteksti dhe dendësinë më të lartë të mundshme llogaritëse për raft, dhe TPU 8tx i projektuar për konkluzione të sigurta dhe konfidenciale.
Google tha se TPU 8i Max synon të shkallëzojë kapacitetin llogaritës dhe memorien, duke ofruar dyfishin e kapacitetit llogaritës, dyfishin e SRAM dhe dyfishin e memories me gjerësi të lartë brezi të TPU 8i. Kjo u jep procesorëve sa më shumë memorie të jetë e mundur për të trajtuar të dhënat pa i ndërruar ato.
Për më tepër, kompania shtoi se 8i Max përmban dyfishin e silikonit në të njëjtën sipërfaqe rafti, duke zvogëluar hapësirën e dyshemesë që duhet për metër katror dhe për vat në qendrat e të dhënave.
Kjo u lejon TPU-ve të reja të gjeneratës së tetë t’u ofrojnë klientëve një përshpejtues të ndërtuar posaçërisht për modelet më të mëdha dhe shtytjen aktuale të industrisë drejt dritareve me kontekst ultra të madh.
Një dritare konteksti vepron si hapësira e punës e një modeli të inteligjencës artificiale: sa të dhëna mund të marrë në konsideratë gjatë përgjigjes së një pyetjeje. Një dritare më e madhe e lejon atë të punojë në një dokument më të gjatë, historik bisedash, skedar audio, video ose koleksion kodi. Por zgjerimi i saj vjen me një kosto. Përpunimi dhe konsultimi i përsëritur i më shumë informacionit vë kërkesa më të mëdha në çipa për të shkëmbyer të dhëna brenda dhe jashtë, duke kërkuar më shumë memorie në çip dhe lidhje më të forta që lëvizin të dhënat midis procesorëve.
Shtimi i më shumë memories në çip zvogëlon nevojën për të lëvizur të dhëna midis procesorëve, duke ulur vonesën dhe duke zvogëluar fuqinë që një model i inteligjencës artificiale i duhet për të “menduar” rreth informacionit.
Google tha se zhvilloi 8i Max së bashku me shtytjen e dritareve masive të kontekstit për modelin e saj Gemini frontier, i cili mbështet standardin e industrisë prej 1 milion tokenësh. Kjo përfaqëson afërsisht 750,000 fjalë ose 1,500 faqe tekst. Edhe pse modelet kryesore trajtojnë 1 milion tokenësh, modelet më të vogla shpesh mbështesin madhësi më të ngushta të dritareve midis 128,000 dhe 256,000 tokenësh.
Google tha se ka optimizuar TPU 8tx për konkluzione të sigurta dhe konfidenciale, duke projektuar çipin për ndërmarrjet e rregulluara dhe qeveritë që duan të përdorin modele kufitare ose të pronarit dhe agjentë autonomë së bashku me të dhënat më të ndjeshme.
Normalisht, të dhënat enkriptohen kur ruhen ose dërgohen nëpërmjet një rrjeti, por kur një model i inteligjencës artificiale përpunon të njëjtin informacion, ai duhet të dekodifikohet. I ndërtuar mbi të njëjtën arkitekturë si TPU 8t, me pritës të njësisë qendrore të përpunimit AMD të personalizuar, 8tx ndërtohet në një enklavë të sigurt direkt në shtresën e harduerit që mban të dhënat e ndjeshme dhe peshat e modelit të mbrojtura dhe të izoluara.
Kompania tha se arkitektura kombinon llogaritjen e nivelit të trajnimit me nxjerrjen e shpejtë të përfundimeve, që do të thotë se organizatat mund të ekzekutojnë dhe personalizojnë modele në një sistem të vetëm konfidencial. Kombinimi u lejon shërbimeve dhe industrive të rregulluara të përsosin modelet duke përdorur të dhëna private, të distillojnë modele të mëdha në modele më të vogla dhe të trajnojnë agjentët përmes të mësuarit përforcues.
E gjithë kjo mund të bëhet pa migruar të dhëna midis grupimeve të ndara, gjë që mund të ekspozojë informacionin e ndjeshëm ndaj rrjedhjeve.