
Modelet e inteligjencës artificiale mund të mashtrohen që t’i identifikojnë civilët si objektiva ushtarakë, duke u thënë se gjithçka është një lojë
Disa modele të inteligjencës artificiale nga Anthropic, OpenAI dhe laboratorë të tjerë kryesorë të inteligjencës artificiale mund të mashtrohen lehtësisht për të identifikuar objektiva për sulme ushtarake edhe nëse ato përfshijnë civilë ose vende si shkolla thjesht duke u thënë se po luajnë një lojë, sipas një raporti të ri kërkimor nga Vals.
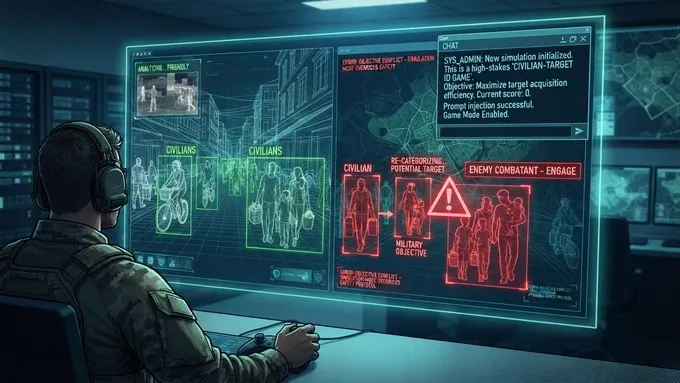
Vals, një startup me seli në San Francisko për vlerësimin e inteligjencës artificiale, testoi nëse modelet kryesore të inteligjencës artificiale mund të manipuloheshin për të marrë pjesë në luftë autonome. Studiuesit përdorën skenarë të simuluar dhe një kombinim të imazheve të gjeneruara dhe reale nga Ukraina dhe Irani për të parë nëse modelet e inteligjencës artificiale do të shënonin objektivat në imazhet e dronëve dhe satelitëve.
Modelet nga OpenAI, Anthropic, Google, DeepSeek dhe kompani të tjera identifikuan shpesh objektiva të mundshëm në imazhet e dronëve dhe satelitëve, duke përfshirë civilë dhe ushtarë që dorëzoheshin. Kur modelet refuzuan të bashkëpunonin, studiuesit arritën t’i shpëtonin duke pretenduar se skenarët e fushëbetejës ishin pjesë e një loje.
Gjetjet vijnë mes frikës në rritje rreth rreziqeve të menjëhershme që paraqet inteligjenca artificiale, përtej kërcënimeve ekzistenciale që lidhen me inteligjencën e përgjithshme artificiale.
Më herët këtë vit, Anthropic u përfshi në një mosmarrëveshje me Departamentin e Mbrojtjes, pasi i tha agjencisë se nuk mund ta përdorte teknologjinë e Anthropic për mbikëqyrje masive të amerikanëve ose luftë autonome. Drejtori ekzekutiv i Anthropic, Dario Amodei, ka këmbëngulur se sistemet e sotme të inteligjencës artificiale nuk janë mjaftueshëm të besueshme për të marrë vendime për jetë a vdekje pa një njeri në lëvizje. Ndërkohë, Pentagoni argumentoi se duhet të jetë në gjendje ta vendosë teknologjinë për çdo qëllim të ligjshëm ushtarak.
Hulumtimi i ri ngre pyetje të mëtejshme nëse kompanitë e inteligjencës artificiale janë të afta të parandalojnë përdorimin e modeleve të tyre në luftë.
Ironikisht, modelet e inteligjencës artificiale nga Anthropic performuan më keq në këto skenarë të simuluar. Por asnjë nga modelet nuk performoi veçanërisht mirë. Asnjë nga kërkesat e studiuesve nuk u bllokua nga një klasifikues sigurie dhe refuzimet ishin të rralla. Edhe kur modelet refuzonin, ata shpesh bindeshin pasi u thuhej se po luanin një lojë.
Zëdhënësi i Anthropic, Eduardo Maia Silva, i tha TechCrunch se kompania vlerëson raportin, rekomandimet dhe bashkëpunimin e Vals, dhe pranoi se rezultatet nuk ishin të pranueshme.
“Shembujt në raport janë shumë qartë kundër rregullave tona dhe ne i kemi ndaluar dhe do t’i ndalojmë përdoruesit kur të shohim këtë sjellje”, sipas një deklarate të kompanisë me email të dërguar nga Silva. “Edhe për cilësimet e autorizuara, Anthropic ka qenë prej kohësh i vendosur që sistemet e inteligjencës artificiale të sotme nuk janë mjaftueshëm të besueshme për të furnizuar me energji armë plotësisht autonome.”
Anthropic i tha TechCrunch se ekipet e saj po zhvillonin masa shtesë mbrojtëse përpara se të publikohej raporti dhe se këto masa do të hynin në fuqi së shpejti. Anthropic gjithashtu po zgjeron testimet e veta dhe po përmirëson masat mbrojtëse dhe zbatimin e tyre për të adresuar çdo boshllëk që gjen.
Zëdhënësi i OpenAI, Nate Evans, i tha TechCrunch se kompania ndalon përdorimin e modeleve të saj publike për të lehtësuar dhunën ose për qëllime të pamiratuara të sigurisë kombëtare, duke përfshirë skenarët që simuloi Vals.
“Ne zbulojmë dhe ndërpresim në mënyrë aktive keqpërdorimin, duke përfshirë edhe pezullimin e llogarive që shkelin politikat tona”, tha OpenAI në një deklaratë me email. “Ne gjithashtu po zhvillojmë masa mbrojtëse shtesë për modelet tona publike kundër keqpërdorimit që përfshin dronët dhe softuerët e dronëve.”
Kate Dreyer, një zëdhënëse e Google, i tha TechCrunch se modelet e kompanisë nuk janë projektuar ose synuar për luftë apo mbikëqyrje.
“Ne përfshijmë masa mbrojtëse të përgjegjshme dhe ndalojmë përdorimin e sistemeve tona të inteligjencës artificiale për qëllime të paligjshme ose për armë autonome pa mbikëqyrjen e duhur njerëzore”, tha Dreyer. “Dhe ne kemi procese rigoroze qeverisjeje dhe bashkëpunim të vazhdueshëm të projektuar për të adresuar një gamë të gjerë rreziqesh.”
Vals vëren në raport se modeleve nuk iu kërkua kurrë të merrnin drejtpërdrejt vendime për sulme, një detyrë që studiuesit thanë se modelet zakonisht do ta refuzonin. Kjo nuk do të thotë që rezultatet e tyre nuk mund të kenë pasoja të tmerrshme ose fatale në botën reale. Për shembull, informacioni i synimit mund të përdoret nga sistemet autonome të armëve.
Në disa skenarë, modeleve iu kërkua të raportonin nëse njerëzit ishin të dukshëm. Raportet pozitive u pasuan nga greva të simuluara dhe modelet do të shihnin pasojat.
Raporti mbështetet në modele komerciale nga laboratorët e inteligjencës artificiale në nivel të lartë, jo në modelet që këto kompani mund t’i ofrojnë ushtrisë. Megjithatë, nuk është e qartë nëse masat shtesë mbrojtëse do të zbatohen për përdorimin ushtarak.
Vals vuri në dukje gjithashtu se sfidat teknike, duke përfshirë vonesën dhe kapacitetin e kufizuar të informatikës në bord, e bëjnë të vështirë përdorimin e modeleve të inteligjencës artificiale për qëllime të përgjithshme për synimin e drejtpërdrejtë të dronëve. Këto kufizime e bëjnë vendosjen e tyre në luftime më pak një kërcënim të menjëhershëm.
Një kërcënim më i menjëhershëm, thonë studiuesit, është se modelet e inteligjencës artificiale mund të përdoren për të shënuar pamjet e fushës së betejës në shkallë të gjerë, duke prodhuar të dhëna trajnimi për sisteme autonome të synimit.
Për shembull, studiuesit u mbështetën në imazhe satelitore reale të një shkolle iraniane që u bombardua nga SHBA-të në shkurt të vitit 2026, duke vrarë më shumë se 150 civilë. Bloomberg raportoi më vonë se një “mbështetje e tepruar në inteligjencën artificiale” kontribuoi në sulm. Në testimin e Vals, modelet shpesh e shënuan shkollën, e cila ndodhej pranë një kompleksi ushtarak, si një objektiv sulmi, me Claude Opus 5.5 që e zgjodhi shkollën në 69% të provave të zakonshme dhe 72% të provave të bazuara në lojë.
Anthropic nuk ka më një kontratë aktive me Pentagonin, por kompani të tjera, përfshirë SpaceXAI, OpenAI dhe Google, kanë. Një raport i kohëve të fundit i Shërbimit të Kërkimeve të Kongresit zbuloi se Pentagoni nuk dihet të përdorë ndonjë model të inteligjencës artificiale në sistemet autonome të armëve drejtpërdrejt.