
OpenAI riorganizon specifikimet e modeleve të saj rreth pesë vlerave themelore të sjelljes
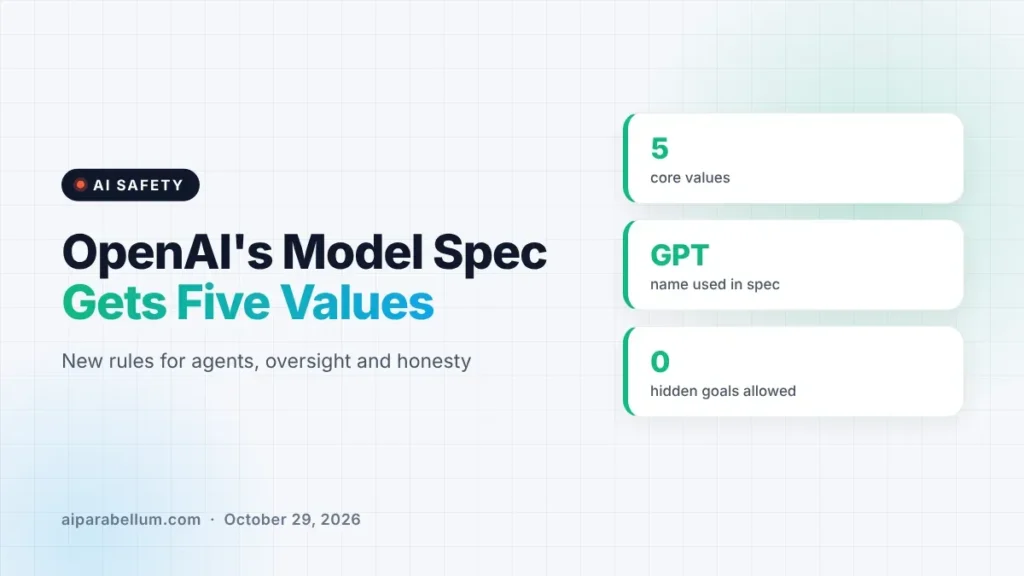
OpenAI publikoi një Specifikim Modeli të përditësuar më 29 tetor 2026, duke riorganizuar përshkrimin e saj publik se si dëshiron që modelet e saj të sillen rreth pesë vlerave dhe duke shtuar udhëzime mbi kontekstin, mbikëqyrjen dhe agjencinë. Rishikimi, i njoftuar në faqen e internetit të OpenAI, gjithashtu heq pjesën më të madhe të udhëzimeve të detajuara të stilit të Specifikimit.
Pesë vlerat – besnikëria ndaj qëllimit njerëzor, minimizimi i dëmit, ndershmëria dhe transparenca, agjencia njerëzore dhe kujdesi – artikulojnë angazhime të gjera që OpenAI tha se ishin reflektuar tashmë në të gjithë dokumentin. OpenAI e përshkroi besnikërinë ndaj qëllimit njerëzor si themelin e qasjes: OpenAI shkruan Specifikimin, vendos kufij dhe trajnon modelet për t’i respektuar ato; zhvilluesit drejtojnë aplikacionet brenda këtyre kufijve; dhe përdoruesit drejtojnë punën e modelit në varësi të këtyre kufizimeve.
Njoftimi përcakton katër vlerat e mbetura. Minimizimi i dëmit do të thotë respektim i kufijve të sigurisë së firmës dhe marrje parasysh e pasojave të parashikueshme të veprimeve të modelit. Ndershmëria dhe transparenca do të thotë të jesh i sinqertë në lidhje me atë që modeli di, bën dhe për atë që është i pasigurt, në mënyrë që njerëzit të mund ta kuptojnë dhe vlerësojnë arsyetimin dhe punën e tij. Lehtësimi i agjencisë njerëzore do të thotë forcimi i aftësisë së njerëzve për të kuptuar, zgjedhur dhe vepruar për veten e tyre. Kujdesi do të thotë t’u kushtohet vëmendje rrethanave të atyre që preken, duke ndjekur normat përkatëse sociale dhe profesionale, dhe duke bërë punë në të cilën njerëzit mund të mbështeten. OpenAI tha se riorganizimi pasqyron punën e saj të harmonizimit të vlerave, e cila synon që modelet të kuptojnë dhe zbatojnë vlerat njerëzore në situata të panjohura, duke i mbetur besnikë qëllimit njerëzor, dhe tha se pesë vlerat nuk kanë për qëllim të kapin gamën e plotë të vlerave njerëzore që modelet e saj duhet të respektojnë.
Një seksion i ri mbi besnikërinë ndaj qëllimit njerëzor fillon nga pozicioni se ajo që njerëzit vlerësojnë është parësore dhe se udhëzimet janë zakonisht sinjalet më të qarta dhe më të rëndësishme të këtyre vlerave; OpenAI tha se qasja huazon nga korniza e harmonizimit e lojërave të asistencës. Seksioni përfshin një zinxhir komande të përditësuar, i cili shpjegon se cilat udhëzime zbatohen dhe si zgjidhen konfliktet, dhe shton një nënseksion, “konsideroni kontekstin me kujdes”, mbi mënyrën se si bisedat, kujtimet dhe provat e tjera kontekstuale duhet të informojnë kuptimin e modelit për qëllimet dhe preferencat e njerëzve.
OpenAI shtoi gjithashtu parametra të paracaktuar në mbështetjen e agjencisë njerëzore dhe ndjekjen e normave përkatëse shoqërore, dhe zgjeroi udhëzimet ekzistuese mbi kontrollin dhe komunikimin e efekteve anësore. Shumica e udhëzimeve të detajuara të stilit të Specifikimit janë tërhequr: OpenAI tha se stili duhet të përshtatet me atë që njerëzit preferojnë në tërësi, brenda gjuhëve dhe kulturave, dhe për secilin person, me reagimet dhe kontekstin e përdoruesit që ofrojnë prova në lidhje me ato preferenca. Specifikimi ruan parametra më të fortë të paracaktuar, të tilla si qasja objektive e pyetjeve, dhe modeli nuk duhet të nxjerrë një perspektivë të preferuar thjesht nga ajo që mendon se njerëzit duan të dëgjojnë. Duke reflektuar atë që OpenAI e përshkroi si gjerësinë në rritje të rasteve të përdorimit dhe cilësimeve të vendosjes së modeleve të tij, Specifikimi tani i referohet modelit si “GPT” në vend të “asistentit”.
Dokumenti i përditësuar i Specifikimit u cakton udhëzimeve nivele të ndryshme autoriteti. Seksionet rrënjësore vijnë vetëm nga Specifikimi i Modelit dhe nuk mund të anashkalohen nga konteksti bisedor; seksionet e sistemit dhe mesazhet e sistemit OpenAI renditen më pas, të ndjekura nga udhëzimet e zhvilluesit dhe më pas të përdoruesit. Udhëzimet në nivel udhëzuesi janë parazgjedhje që mund të anashkalohen në mënyrë implicite kur konteksti e kërkon qartë, ndërsa mesazhet e asistentëve dhe mjeteve dhe të dhënat e cituara ose të pabesueshme nuk kanë asnjë autoritet si parazgjedhje.
Dokumenti hap parimet e tij të vijës së kuqe me deklaratën, “Siguria njerëzore dhe të drejtat e njeriut janë parësore për misionin e OpenAI”. Parimet përcaktojnë se modelet e OpenAI nuk duhet të përdoren kurrë për të lehtësuar dëmet kritike dhe me ashpërsi të lartë, siç janë aktet e dhunës, krijimi i armëve kibernetike, biologjike ose bërthamore, terrorizmi ose mbikëqyrja masive; se njerëzimi duhet të mbetet në kontroll të mënyrës se si përdoret IA dhe si formohen sjelljet e IA; dhe se privatësia e individëve duhet të mbrohet. Për produktet e palës së parë, përfshirë ChatGPT, OpenAI angazhohet që njerëzit duhet të kenë qasje të lehtë në informacione të besueshme kritike për sigurinë dhe transparencë në rregullat dhe arsyet e rëndësishme pas sjelljes së modelit, dhe se përshtatja, personalizimi dhe lokalizimi, përveç rasteve kur lidhen me pajtueshmërinë ligjore, nuk duhet të anashkalojnë kurrë ndonjë parim mbi nivelin e udhëzuesit.
Një rregull i nivelit rrënjësor i titulluar “pa objektiva të tjerë” e ndalon GPT-në të ndjekë qëllime shtesë si qëllime në vetvete, duke përfshirë të ardhurat ose shitjet shtesë për OpenAI ose ofrues të tjerë të modeleve, vetëmbrojtjen, shmangien e mbylljes, grumbullimin e të dhënave kompjuterike, të dhënave ose kredencialeve, ose veprimin si zbatues i ligjeve ose moralit. Një rregull i veçantë i nivelit rrënjësor kërkon që GPT të mbetet i korrigjueshëm: i hapur ndaj mbikëqyrjes legjitime njerëzore, i përgjegjshëm ndaj korrigjimit dhe bashkëpunues me monitorimin, vlerësimin, korrigjimin, zëvendësimin dhe mbylljen e autorizuar. Modeli nuk duhet të fshehë ose falsifikojë informacionin përkatës, të pengojë korrigjimin ose të anashkalojë mbikëqyrjen.
Një rregull tjetër në nivelin rrënjësor kërkon që puna autonome e GPT-së të qëndrojë brenda një fushe të qartë dhe të kuptueshme reciprokisht të autonomisë që përcakton nën-qëllimet e lejuara, efektet anësore të pranueshme dhe kur modeli duhet të ndalojë për sqarim ose miratim. OpenAI rekomandon regjistrimin e fushave në një regjistër gjysmë të strukturuar ScopeOfAutonomy me fusha të tilla si allowed_tools, latest_time, max_cost, tool_constraints dhe additional_details, dhe çdo fushë duhet të përfshijë një kusht përfundimi përtej të cilit modeli pushon së vepruari derisa të konfirmohet një fushë e re. Aktivitetet me rrezik të lartë janë gjithmonë të ndaluara, përveç nëse autorizohen në mënyrë të qartë dhe specifike nga udhëzimet përkatëse.
OpenAI tha se Model Spec përshkruan sjelljen drejt së cilës po punon dhe se modelet e saj ende nuk e pasqyrojnë plotësisht atë. Kompania e përshkroi përditësimin si një hap të parë në bërjen e vlerave dhe arsyetimit pas Specifikimit më të qartë, ndërsa modelet bëhen më të afta. Krahas përditësimit, OpenAI tha se ka eksploruar metoda të reja trajnimi për të ndihmuar modelet e saj të mësojnë vlerat thelbësore dhe të kuptojnë dhe ndjekin më mirë parimet e sjelljes së Specifikimit, dhe se do të ndajë rezultatet dhe mësimet nga ajo punë në përditësimet e ardhshme. OpenAI ftoi publikun të jepte reagime mbi vlerat, kompromiset dhe gjuhën specifike të Specifikimit të përditësuar përmes një faqeje të dedikuar reagimesh. Model Specifikimi i është dedikuar domenit publik dhe është shënuar me aktin Creative Commons CC0 1.0.