
Nvidia përgjysmon RAM-in e DGX Spark për shkak të mungesës së memories
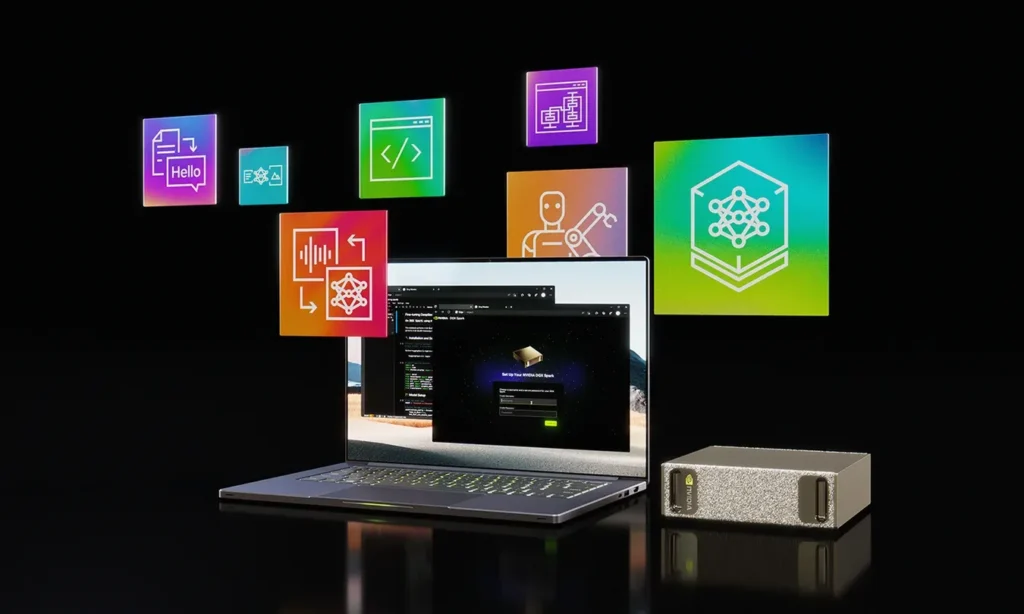
Një entuziast i inteligjencës artificiale mund të shpenzojë një sasi të paarsyeshme kohe duke u përpjekur ta bëjë një model të bëjë diçka për të cilën nuk është projektuar tamam. Jepini një koleksion privat dokumentesh. Jepini një bazë kodi dhe shikoni nëse i kupton konventat. Përsosni një model të hapur, ndryshoni të dhënat, ekzekutojeni përsëri dhe krahasoni rezultatet. Pasi një eksperiment të funksionojë, pyetja tjetër tenton të lindë shpejt: a mund të marrë modeli përsipër një pjesë më të madhe të punës, ndoshta si një agjent që mund të përdorë mjete dhe të punojë në disa hapa pa u nxitur në çdo hap?
NVIDIA DGX Spark 64GB, e disponueshme ekskluzivisht përmes partnerëve OEM Acer, ASUS, Dell, Gigabyte, HP dhe MSI, është ndërtuar pikërisht për këtë lloj ndërhyrjeje. Sistemi kompakt i desktopit kombinon NVIDIA GB10 Grace Blackwell Superchip me 64GB memorie të unifikuar koherente dhe paketën e softuerëve IA të kompanisë, duke krijuar një platformë lokale për rregullimin e imët të modelit, nxjerrjen e përfundimeve dhe agjentët autonomë të IA-së. Ajo vjen me rrjetëzim të integruar ConnectX-7 për t’u shkallëzuar në grupe shumë-Spark ndërsa ngarkesat e punës rriten. NVIDIA po e pozicionon konfigurimin 64GB drejt zhvilluesve, studiuesve, studentëve, shkencëtarëve të të dhënave dhe entuziastëve të IA-së që duan të ndërtojnë me modele lokale në vend që thjesht t’i qasen atyre përmes një shërbimi cloud.
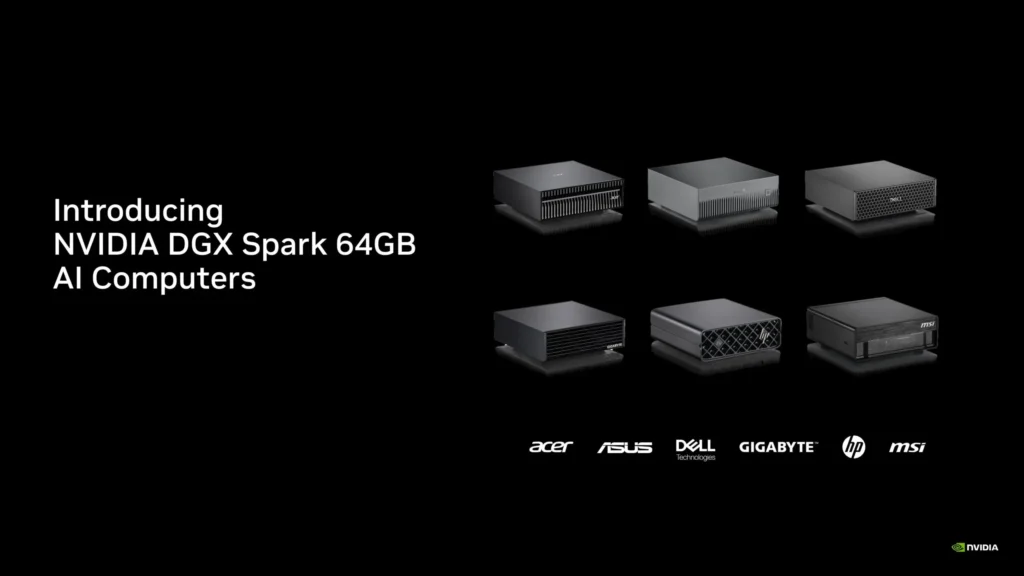
Një desktop konvencional mund të përballojë shumë eksperimentime me IA deri sa eksperimenti të bëhet më ambicioz. Ekzekutimi i një modeli është relativisht i thjeshtë; mbajtja e një modeli më të madh, kontekstit të tij dhe pjesëve mbështetëse të një aplikacioni në dispozicion në të njëjtën kohë është një çështje tjetër. DGX Spark i qaset problemit nga ana tjetër, duke e vendosur llogaritjen dhe memorien e IA-së në qendër të dizajnit në vend që ta trajtojë IA-në lokale si diçka që një PC me qëllim të përgjithshëm e mbështet.
IA lokale bëhet shumë më e dobishme pasi modeli të mos trajtohet më si një produkt i përfunduar. Një zhvillues që ndërton një asistent kodimi, për shembull, mund të mos dëshirojë një model të përgjithshëm që thjesht di si të programojë. Përmirësimi i një modeli ekzistues kundrejt një baze të caktuar kodi mund të krijojë një pikënisje shumë të ndryshme për eksperimentet e ardhshme, veçanërisht kur zhvilluesi dëshiron të testojë se sa mirë modeli e kupton mënyrën se si është shkruar në të vërtetë softueri.
NVIDIA identifikon posaçërisht këtë rrjedhë pune për DGX Spark. Zhvilluesit mund të përsosin një LLM ekzistuese duke përdorur kodin e tyre burimor të softuerit dhe më pas të ekzekutojnë modelin që rezulton në nivel lokal për detyrat e zhvillimit në të ardhmen. I njëjti konfigurim mund të mbështesë gjithashtu projekte të vizionit kompjuterik, testimin lokal të inferencës dhe punën e shkencës së të dhënave, duke u dhënë zhvilluesve hapësirë për të kaluar nga trajnimi dhe eksperimentimi në testim pa e zhvendosur menjëherë ngarkesën e punës diku tjetër.
Pajisjet bëhen pjesë e atij cikli krijues sepse distanca midis një ideje dhe një testi zvogëlohet. Një zhvillues mund ta ndryshojë modelin, ta ekzekutojë atë lokalisht, të inspektojë rezultatin dhe të provojë përsëri pa dërguar çdo përsëritje në një shërbim të jashtëm të nxjerrjes së përfundimeve. Prandaj, informatika lokale ka më pak të bëjë thjesht me mbajtjen e një modeli jashtë linje dhe më shumë me dhënien e kontrollit të drejtpërdrejtë mbi eksperimentin personit që ndërton me të.
DGX Spark 64GB është projektuar rreth këtij fluksi pune. GB10 Grace Blackwell Superchip kombinon një GPU Blackwell me një CPU me 20 bërthama, ndërsa NVLink-C2C krijon një arkitekturë koherente memorieje që lejon procesorin dhe GPU-në të punojnë nga i njëjti grup memorieje. NVIDIA e vlerëson sistemin për deri në 1 petaFLOP të performancës FP4 AI, me 273GB/s bandwidth memorieje.
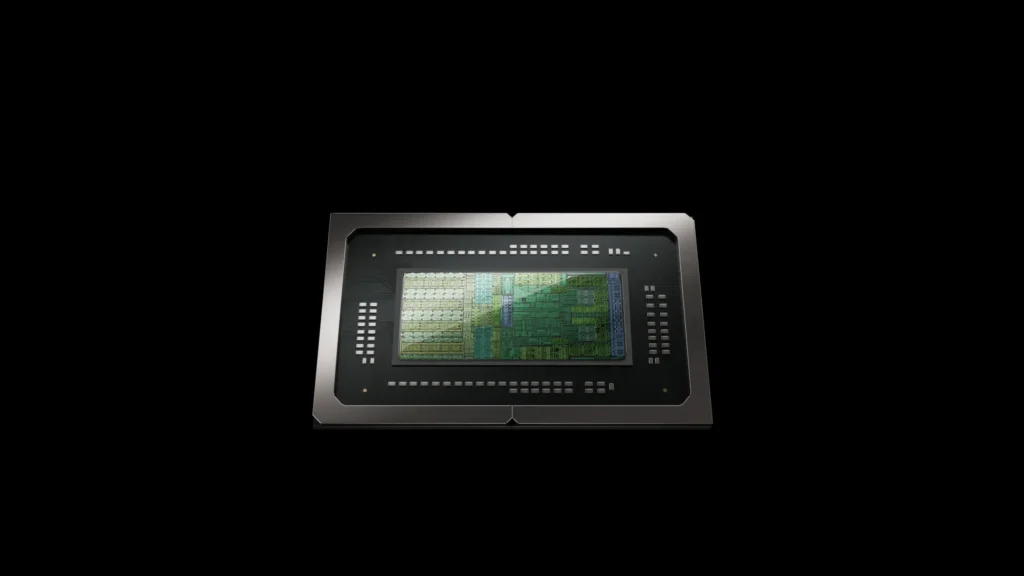
Kujtesa është e lehtë të anashkalohet kur flitet për pajisjet e inteligjencës artificiale, sepse GPU-ja zakonisht merr vëmendjen kryesore. Modelet lokale e bëjnë kujtesën shumë më të vështirë për t’u injoruar. Modeli ka nevojë për hapësirë për t’u ekzekutuar, por po kështu edhe kontekstet më të gjata, modelet shtesë dhe pjesët e tjera të një aplikacioni të ndërtuara rreth tij. Një makinë që trajton një model në mënyrë të qetë mund të bëhet shumë më pak e rehatshme kur ngarkesa e punës fillon të sillet si një aplikacion i vërtetë.
NVIDIA e pozicionon konfigurimin 64GB rreth modeleve më të reja të hapura, duke përfshirë Qwen3.8-27B, Meta Muse Glimmer dhe NVIDIA Nemotron 3.5 Lightning. Kompania i përshkruan këto modele si modele që ofrojnë aftësi të krahasueshme me modelet e nivelit të lartë vetëm disa muaj më parë, ndërsa përshtaten brenda një hapësire memorieje prej 64GB. Duke përdorur rrjetëzimin CX-7 dhe NVIDIA Sync Cluster Assistant, dy sisteme 64GB mund të grupohen pa probleme për të bashkuar 128GB memorie dhe për të ekzekutuar modele më të mëdha dhe ngarkesa pune më të mëdha.
Përfitimi i këtij kapaciteti nuk është thjesht mundësia për të treguar një numër më të madh në një fletë specifikimesh. Më shumë memorie i jep një entuziasti hapësirë për të mbajtur në dispozicion kontekst më të pasur, për të ekzekutuar ngarkesa pune mbështetëse së bashku me modelin dhe për të eksperimentuar me aplikacione lokale gjithnjë e më të ndërlikuara përpara se vetë hardueri të bëhet faktori kufizues.
NVIDIA është përpjekur gjithashtu të heqë disa nga vështirësitë që zakonisht shoqërojnë një konfigurim lokal të IA-së. DGX Spark përdor DGX OS dhe vjen me paketën e softuerëve të IA-së të përshpejtuar NVIDIA CUDA, duke përfshirë PyTorch, Jupyter dhe Ollama për prototipizim, rregullim të imët dhe nxjerrje përfundimesh.
Një agjent autonom ndryshon natyrën e eksperimentit sepse modeli nuk pritet më të japë një përgjigje dhe të ndalojë. Një agjent kodimi mund të inspektojë një projekt, të identifikojë një problem, të bëjë një ndryshim, të testojë rezultatin dhe të vazhdojë nga ajo që ka mësuar. Një rrjedhë pune kërkimore mund të përfshijë disa modele të specializuara, thirrje mjetesh dhe një gjurmë të gjatë konteksti që duhet të mbetet e disponueshme ndërsa detyra përparon.
DGX Spark është projektuar për ato ngarkesa pune, ku modele dhe agjentë të shumtë mund të ndajnë të njëjtin grup të madh memorieje. NVIDIA e përshkruan në mënyrë specifike sistemin si një platformë për arsyetim me kontekst të gjatë, tubacione shumë-agjentësh dhe inferencë lokale, ndërsa NVIDIA OpenShell ofron kontrolle të privatësisë dhe sigurisë të bazuara në politika për ngarkesat e punës së agjentëve.
Një entuziast nuk ka nevojë të ndërtojë një sistem të gjerë me shumë agjentë për të përdorur harduerin. Një projekt i parë më i besueshëm mund të jetë një agjent që punon përmes një grupi të dhënash personale, kontrollon një projekt softueri, organizon informacionin ose trajton një sekuencë detyrash të përsëritura. Llogaritja lokale i bën këto eksperimente më të lehta për t’u përsëritur sepse personi që ndërton rrjedhën e punës kontrollon modelet, të dhënat dhe mjedisin në të cilin funksionon gjithçka.
Shërbimet cloud ende kanë një rol të dukshëm kur një projekt kërkon sasi të mëdha llogaritjesh. Pajisjet lokale ndryshojnë ekuacionin për eksperimentimin që ndodh përpara se një projekt të arrijë atë shkallë, veçanërisht kur çdo kërkesë shtesë për përfundim do të shtonte një kosto tjetër përdorimi. NVIDIA e pozicionon DGX Spark si një mënyrë për të mbajtur modelet, kërkesat, të dhënat dhe përfundimet në pajisje pa tarifa përfundimi cloud për çdo shenjë.
Një projekt që fillon me një makinë nuk është domosdoshmërisht i detyruar të qëndrojë aty. NVIDIA ka ndërtuar rrjetëzim në DGX Spark në mënyrë që sisteme të tjera të mund të bëhen pjesë e të njëjtit mjedis lokal të inteligjencës artificiale ndërsa ngarkesat e punës rriten.
Dy sisteme DGX Spark 64GB mund të lidhen për të krijuar një pishinë memorieje prej 128GB dhe deri në 2 PFLOPS të llogaritjes totale të IA-së. NVIDIA thotë se çifti mund të ofrojë deri në 1.7 herë performancën e një sistemi DGX Spark 128GB në konfigurimin e përshkruar në udhëzimet e saj. ConnectX-7 ofron ndërlidhjen me shpejtësi të lartë, ndërsa NVIDIA Sync mund të zbulojë sistemet dhe të ndihmojë në konfigurimin e klasterit përmes Ndihmësit të saj të Klasterit.
Konfigurimet më të mëdha e zgjerojnë idenë më tej. NVIDIA përshkruan grupe deri në katër sisteme DGX Spark, duke krijuar rezerva memorieje të përbashkëta dukshëm më të mëdha për modele dhe ngarkesa pune që tejkalojnë kapacitetin e një njësie të vetme. Materiali i saj teknik gjithashtu përshkruan ngarkesa pune të inferencës së shpërndarë dhe rregullimit të imët të projektuara për t’u shkallëzuar në sisteme të shumëfishta.
NVIDIA Sync është i dobishëm këtu pikërisht sepse mund të qëndrojë në sfond. Softueri mund të zbulojë sisteme të lidhura, të konfigurojë rrjetin, të drejtojë ngarkesat e punës dhe të monitorojë gjendjen e sistemit, duke i lejuar zhvilluesit të përqendrohet në projektin e inteligjencës artificiale në vend që ta kthejë konfigurimin e klasterit në një projekt të veçantë.
Dizajni fizik e bën propozimin edhe më të pazakontë. DGX Spark ka përmasa 150 mm me 150 mm me 50.5 mm dhe peshon 1.2 kg, megjithatë hardueri është projektuar për ngarkesa pune që përfshijnë modele të mëdha, inferencë lokale dhe agjentë autonomë. NVIDIA gjithashtu e përshkruan sistemin si mjaftueshëm efikas në energji për t’u përdorur nga një prizë standarde muri, duke e bërë atë praktik për ngarkesa pune që duhet të mbeten aktive në vend që të ndizen vetëm kur dikush ulet në një stacion pune.
DGX Spark 128 GB do të vazhdojë të jetë i disponueshëm përmes NVIDIA dhe të gjithë partnerëve OEM për përdoruesit që kanë nevojë për më shumë memorie, duke i dhënë platformës një konfigurim tjetër ndërsa ngarkesat lokale të punës rriten. Modeli 64GB, megjithatë, përbën pikënisjen më interesante për dikë që dëshiron të eksperimentojë me inteligjencën artificiale lokale duke përdorur gjeneratën më të fundit të modeleve të vogla me burim të hapur.
Gjëja interesante në lidhje me vendosjen e kaq shumë aftësive të IA-së në një tavolinë është ajo që bën në pikën fillestare të një eksperimenti. Një zhvillues nuk ka nevojë të fillojë duke vendosur se cilin shërbim cloud të përdorë ose sa kohë kompjuterike meriton një projekt. Modeli, të dhënat dhe mjetet mund të jenë të gjitha të arritshme, duke e bërë më të lehtë vazhdimin e rafinimit të një ideje derisa të bëhet diçka e dobishme.
DGX Spark 64GB është projektuar pikërisht për këtë lloj pune. Kombinimi i tij i llogaritjes Grace Blackwell, 64GB memorie të unifikuar dhe paketës lokale të softuerëve të IA-së të NVIDIA-s u jep zhvilluesve dhe entuziastëve të IA-së hapësirë për të punuar me modele më të mëdha, për t’i përsosur ato, për të ndërtuar agjentë dhe për të testuar rezultatet në nivel lokal. Kur një projekt përfundimisht ka nevojë për më shumë memorie ose llogaritje, sistemet shtesë DGX Spark mund të zgjerojnë të njëjtin konfigurim në vend që të detyrojnë një rrjedhë pune krejtësisht të ndryshme.
NVIDIA po zbulon DGX Spark 64GB sot (2 tetor 2026), me sistemin që do të jetë i disponueshëm nga partnerët OEM të NVIDIA më 23 tetor. Për këdo që ka eksperimentuar me modele lokale dhe pyet veten se sa më tej mund të shkojë kjo punë me më shumë memorie dhe llogaritje të dedikuar të AI, këtu bëhet interesant eksperimenti. Pyetja nuk është më thjesht se cilin model të provoni më pas. Është ajo që mund të ndërtoni pasi hardueri ju jep hapësirë të mjaftueshme për të vazhduar ta shtyni përpara idenë.